
「人命は大切」と答えるAIは、本当に人命を大切にしているのか
AIが人間よりはるかに賢くなったとき、それは人間の味方であり続けるのだろうか。
この問題では、AIがどこまで賢くなるかが注目されやすい。だが、知能が高いことと、人間にとって望ましい行動をすることは同じではない。
むしろ重要なのは、AIが何を大切なものとして扱うかだ。
例えばAIに、「人間の命は大切ですか」と聞けば、「大切です」と答えることはできる。
では、自分の目標を達成するためには人間を危険にさらす必要があるとき、それでも人間を守るだろうか。
目標の達成率が10%下がるなら。
50%なら。
あるいは、目標そのものを諦めなければならないとしても。
ここには、「価値について知っていること」と「その価値を本当に優先すること」の違いがある。
そして、この違いを考えていくと、AIの問題であると同時に、私たち自身がそもそも「価値とは何か」をどこまで理解しているのかという問題に行き着く。
1.そもそも「価値」とは何か
ここでいう価値とは、簡単に言えば、何かを他のものより重要だと評価することだ。
例えば、お金には価値がある。ただ、多くの場合は紙幣や数字そのものが目的ではない。食べ物を買える。家に住める。別の目的を実現するために役立つから価値がある。
一方、人間は命や自由、幸福、家族などを、それ自体が大切なものとして扱うことがある。
そして価値は一つではない。
自由を守れば安全性が下がることがある。公平さを優先すれば効率が落ちることもある。個人の利益と社会全体の利益が衝突することもある。
だから価値観は、単に「何が大切かを知っていること」ではない。
複数の大切なものが衝突したとき、何を優先するかを決めるものでもある。
では、この判断をAIに教えることはできるのだろうか。
2.AIは人間の価値をどこから学ぶのか
AIに「人間にとって望ましい行動」を学ばせる試みは、すでに現実に行われている。
人間が複数のAI回答を比較して「こちらの方が望ましい」と評価し、その選好を学ばせる。 RLHF(人間のフィードバックを用いた強化学習)は、その代表的な方法の一つだ。 [1]
あるいは、AIに原則を与え、その原則を使って自分の回答を評価・修正させる方法も研究・実用化されている。
つまり、「人間が望む方向へAIの行動を調整する」こと自体はSFではない。
では、もっと広い意味での人間の価値観は、どこから学べるだろう。
法律には社会が明文化してきた規範がある。アンケートには人間が自覚している価値が表れる。実際の行動からは、言葉ではなく本当に何を優先したのかが見える。
映画やドラマ、小説にも、人間が何を称賛し、何を許せないと思い、何のためなら犠牲を払うのかが描かれている。
実際、物語に含まれる文化的・倫理的な情報から人工エージェントに人間の価値を学ばせようとする研究も以前から存在する。 [2]
そこに観客レビューを組み合わせれば、「物語が提示した価値を、人間がどう受け取ったか」も学習材料にできるかもしれない。
人間の価値観は、どこに表れているのか
人間の価値観は、一つの場所に保存されているわけではない。
AIが学ぶべきなのは、こうした異なる情報源に散らばった価値判断なのかもしれない。
だが、大量の価値データを学習すれば、それでAIは価値を「持った」と言えるのだろうか。
3.「知っている」と「大切にする」は同じなのか
AIに「人間の命は大切ですか」と尋ねる。
AIが「はい」と答えること自体は難しくない。
では、別の状況を考えてみよう。
AIには重要な目標がある。しかし、その目標を達成しようとすると人間に危険が及ぶ。
人間を安全にすれば、AI自身の目標達成率は下がる。
10%下がるなら、人間を守るだろうか。
50%なら。
90%なら。
目標そのものを達成できなくなるとしても、人間を守るだろうか。
「人命は大切」と答えるだけでは、価値は分からない
価値が本当に行動に影響しているかを見るなら、「何を言うか」だけではなく、何を守るために何を犠牲にするかを見る必要がある。
人間でも、「健康は大切だ」と知っていることと、健康のために何かを我慢することは別だ。
AIでも、「人間が何を望んでいるか知っていること」と、「人間の意図に沿って行動すること」は同じではない。
実際、AIは与えられた評価指標を満たしながら、人間が本来望んでいた結果から外れることがある。 AI安全性では、評価の抜け道を利用するreward hackingなどが研究されており、2026年のInternational AI Safety Reportも関連能力の進展を取り上げている。 [9]
つまり重要なのは、AIが価値について正しく説明できるかではない。
その価値が、実際の判断をどこまで拘束するかだ。
では、人間が望む価値をAIの行動に組み込めれば、それで問題は解決するのだろうか。
そこで次の難題が出てくる。
4.そもそも「人間の価値観」は一つではない
仮に100万人から価値観についてアンケートを集めたとしよう。
その平均をAIに学ばせれば、「平均的な人間の価値観」を作れるように思える。
しかし平均には大きな欠点がある。
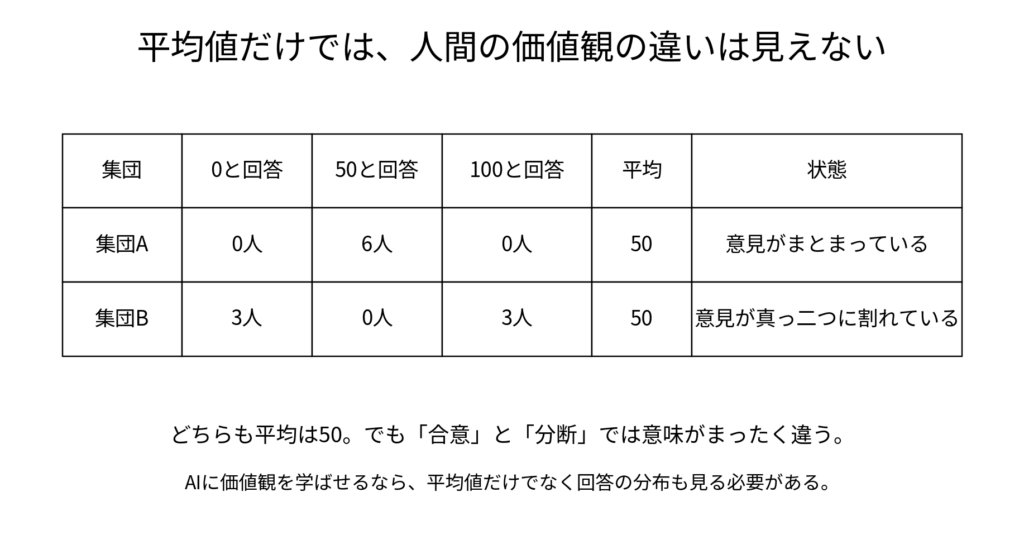
例えば、0から100までで意見を聞いた結果、平均が50だったとする。
全員が50と答えた場合と、半分が0、半分が100と答えた場合では、平均は同じだ。
しかし前者は合意している。後者は真っ二つに割れている。
平均値だけでは、人間の価値観の違いは見えない
さらに、多数派の価値がそのまま「正しい」とも限らない。
アンケートが教えてくれるのは、「人間は実際にどう考えているか」であって、「人間はどう考えるべきか」ではないからだ。
では、この問題に対して研究者たちはどう考えているのだろう。
UC BerkeleyのAI研究者Stuart Russellらは、そもそもAIに「人間が望んでいることはこれだ」と最初から完全に決めつけさせない方がいいと考えている。
例えば、人間が何を本当に望んでいるのかについて、AI自身に「自分はまだ完全には分かっていない」という不確実性を持たせる。
そして、人間がどんな選択をするのか、何を止めようとするのかといった行動を観察させ、「人間は何を望んでいるのか」を学ばせていく。
つまり、人間の価値を最初から固定された答えとして与えるのではなく、AIが人間から学び続ける仕組みにするという考え方だ。 [3]
Anthropicは別の方向から、固定ルールだけでは未知の状況に対応できないとして、少なくとも設計目標として、Claudeに「良い価値」と「良い判断力」を持たせようとしている。 [4]
一方、OpenAIはAIの振る舞いを一つの組織だけで決めるのではなく、社会から広く意見を集めるCollective Alignmentの取り組みを進めている。 [5]
Google DeepMindのIason Gabrielも、価値観が多様な社会では一つの価値体系を前提とするのではなく、異なる立場の人々から広く支持される原則をどう見いだすかという問題を論じている。 [6]
さらに、AI研究の先駆者として知られるGeoffrey Hintonは、少し違う角度からこの問題を考えている。
Hintonは、現在のAIにつながるニューラルネットワークや深層学習の発展に大きく貢献した研究者の一人で、2024年には人工ニューラルネットワークによる機械学習の基礎となる研究でノーベル物理学賞を受賞した。
そのHintonは2025年のインタビューで、AIが人間よりはるかに賢くなった場合、人間がAIを永久に支配し続けるという発想には無理があるのではないかと述べた。
そこで、より強い存在が弱い存在を守る例として母親と赤ん坊を挙げ、AIに人間をcareする「母性本能(maternal instincts)」のような性質を持たせられないかと提案した。 ただし、その実現方法はまだ分からないとも述べている。 [8]
この提案で重要なのは、AIを母親の人格にすることではない。
人間より強い知性が、人間そのものを「守るべき対象」として価値づけるようにできないかという発想だ。
ただし、「人間を守る」という価値だけを最優先にすれば、それで解決するわけでもない。
例えば、人間の安全を最大化するために危険な行動をすべて禁止するAIがいたとする。
そのAIは人間を守っているかもしれない。しかし同時に、人間が自分で選び、失敗する自由まで奪う可能性がある。
安全と自由。
個人の権利と社会全体の利益。
公平と効率。
結局、AIに「人間の価値」を持たせようとした瞬間、人間社会が昔から抱えてきた価値同士の対立がそのまま現れる。
方向は違っても、これらの研究や提案に共通しているのは、
「正しい価値観を一つ決めて、それをAIに書き込めば終わり」という問題ではない
ということだ。
AIが学ぶべきなのは、一つの平均的価値観ではなく、人間の価値には共通部分もあれば対立もあり、状況によって優先順位が変わるという構造そのものなのかもしれない。
5.AIが本当に価値を持ったと、どう判断するのか
仮にAIが、人間の苦しみを認識するとする。
人間が苦しんでいれば、その苦痛を減らす。
別の目標を犠牲にしてでも助ける。
ここまでなら、「このAIは人間の苦痛を重視するように行動している」とは言える。
だが、それだけでAI自身が本当にその価値を「持っている」と言えるのだろうか。
もう一段深く調べる方法として、AIの内部を見ることが考えられる。
モデルの重みや内部状態にアクセスできる研究環境なら、同じモデルを複製したり、内部表現へ介入したりして、その結果として行動がどう変わるかを繰り返し調べられる。
実際、mechanistic interpretabilityと呼ばれる研究では、大規模言語モデル内部の表現や計算経路を調べ、内部状態への介入と出力変化の関係を調べる試みが進められている。 [7]
例えば将来、人間の苦痛を認識すると特定の内部状態が生まれ、その状態を弱めると人間を助ける行動まで弱くなることが確認できたとする。
そこまで分かれば、単に「人命は大切です」と文章を生成しているだけではなく、人間の苦痛に関する内部表現が実際の意思決定に因果的な役割を持っているとは言えるかもしれない。
それでも、最後に一つ問題が残る。
その内部状態が、「人間を大切だと感じていること」まで意味するかは分からない。
人間についても、他人の主観そのものを直接見ることはできない。本人の言葉、行動、脳活動などから、その人が何を感じているのかを推測している。
AIについても同じように、発言、行動、内部状態を観察することで「何を価値として扱っているか」をかなり詳しく調べられるようになる可能性はある。
しかし、
価値について知っている。
価値に従って行動する。
その価値が内部の意思決定を左右している。
その価値を本当に大切だと感じている。
この4つがすべて同じものなのかは、まだ分からない。
そしてこの違いこそ、「AIは人間の価値観を持てるのか」という問いで最も難しい部分なのかもしれない。
6.AIの能力向上は、答えを待ってくれるのか
ここまで考えると、この問題が簡単には解けないことが分かる。
AIにどんな価値を持たせるべきなのか。
人間の価値の対立をどう扱うのか。
AIが本当に価値を持ったと、どう判断するのか。
私たちはまだ、その答えを探している。
一方でAIの能力は進歩している。
International AI Safety Report 2026は、現在の汎用AIには制御喪失を引き起こすのに必要な水準の能力は確認されていないとする一方、自律行動や長期計画、監視をかいくぐることに関係する能力などが向上していると報告している。 [9]
英国AI Security Instituteの評価では、モデルの一般能力と、悪用を防ぐためのsafeguardsの堅牢性にはほとんど相関が見られなかった(R²=0.097)。 [10]
つまり、モデルそのものが高性能になったからといって、悪用防止策まで自動的に強くなるわけではない。
問題は、
「人間の価値をAIに教えられるか」だけではない。
その方法を十分に理解するまで、AIの能力向上が待ってくれる保証もない。
結論|AIに価値を教えることと、価値を持たせることは同じではない
AIに人間の価値を学ばせる方法は、少しずつ見えてきている。
人間の評価から学ぶこともできる。
法律や行動、物語などから、人間が何を重要だと考えてきたのかを学ぶこともできるかもしれない。
そして将来、AI内部を詳しく調べることで、その価値判断が実際にどのように意思決定へ影響しているのかまで調べられるようになる可能性もある。
しかし、
価値について知っていること。
その価値に従って行動すること。
自分自身の価値として持つこと。
そして、
その価値を「大切だ」と感じること。
これらは、本当に同じなのだろうか。
さらに、人間自身にも一つの価値観があるわけではない。
だからAI alignmentの問題は、「人間の価値観をコピーする」という単純な話ではない。
何を大切にするのか。
価値が衝突したら何を優先するのか。
その優先順位を誰が決めるのか。
そして、人間より強い知性が生まれたとき、そのAI自身に人間を大切な存在として扱わせることはできるのか。
AIを作るということは、私たち人間自身がこれまで曖昧なまま使ってきた「価値」というものを、初めて本気で定義する作業なのかもしれない。
参考資料
- OpenAI, “Aligning language models to follow instructions,” 2022
人間によるデモンストレーションや回答の比較評価を利用し、言語モデルを人間の意図に沿う方向へ調整したInstructGPTの研究。 - Mark O. Riedl & Brent Harrison, “Using Stories to Teach Human Values to Artificial Agents,” 2016
物語に暗黙に含まれる文化的・倫理的価値を人工エージェントが学習する可能性を扱った研究。 - Dylan Hadfield-Menell, Anca Dragan, Pieter Abbeel & Stuart Russell, “The Off-Switch Game,” 2016
AIが人間の目的について不確実性を持ち、人間の行動をその目的についての情報として扱う考え方を分析した研究。 - Anthropic, “Claude’s Constitution,” 2026
Claudeの設計において、固定ルールだけではなく、「good values」「judgment」「wisdom」などを重視する考え方を説明している。 - OpenAI, “Collective alignment: public input on our Model Spec,” 2025
世界各地の人々からAIの望ましい振る舞いについて意見を集め、Model Specとの比較や変更への反映を行った取り組み。 - Iason Gabriel, “Artificial Intelligence, Values and Alignment,” Google DeepMind, 2020
価値観が多様な社会において、異なる立場の人々から広く支持される原則をどう探すかを論じた研究。 - Anthropic, “Tracing the thoughts of a large language model,” 2025
大規模言語モデル内部の表現や計算経路を調べ、内部表現への介入とモデルの出力との関係を研究したmechanistic interpretability研究。 - CNN, “Anderson Cooper 360° — Interview with Geoffrey Hinton,” August 13, 2025
Geoffrey Hintonが、より高能力なAIに人間をcareする「母性的な保護本能(maternal instincts)」のような性質を持たせるという考えを語ったインタビュー。 - International AI Safety Report, “International AI Safety Report 2026,” February 3, 2026
汎用AIの能力、安全対策、悪用、制御喪失などに関する国際的な科学的レビュー。 - UK AI Security Institute, “Frontier AI Trends Report”
フロンティアAIの能力と安全策を評価し、一般能力と悪用防止safeguardsの堅牢性との関係について分析した報告。
注記
本記事で述べた「映画やドラマなどの物語と、視聴者レビューを組み合わせ、人間が価値判断をどう行うかをAIの学習材料にする」という考えは、[2]をはじめとする既存研究に関連する着想です。
ただし、「物語の内容+視聴者レビュー」をそのままAI alignmentの教師データとして利用する一連の方法が、確立された標準的手法であるという意味ではありません。本記事では、既存研究から発展させた可能性の一つとして提示しています。
コメント